
Управляемое аварийное переключение
Пример на GitHub: supervised_failover
В Tarantool возможно управление ролью лидера в наборе реплик с помощью внешнего координатора аварийного переключения. Координатор аварийного переключения считывает конфигурацию кластера из файла или из хранилища конфигурации на базе etcd, опрашивает экземпляры для получения их статусов и назначает лидера для каждого набора реплик в зависимости от доступности и состояния экземпляров.
Для повышения отказоустойчивости можно запустить два и более координатора. Тогда синхронизация между ними будет обеспечиваться кластером etcd.
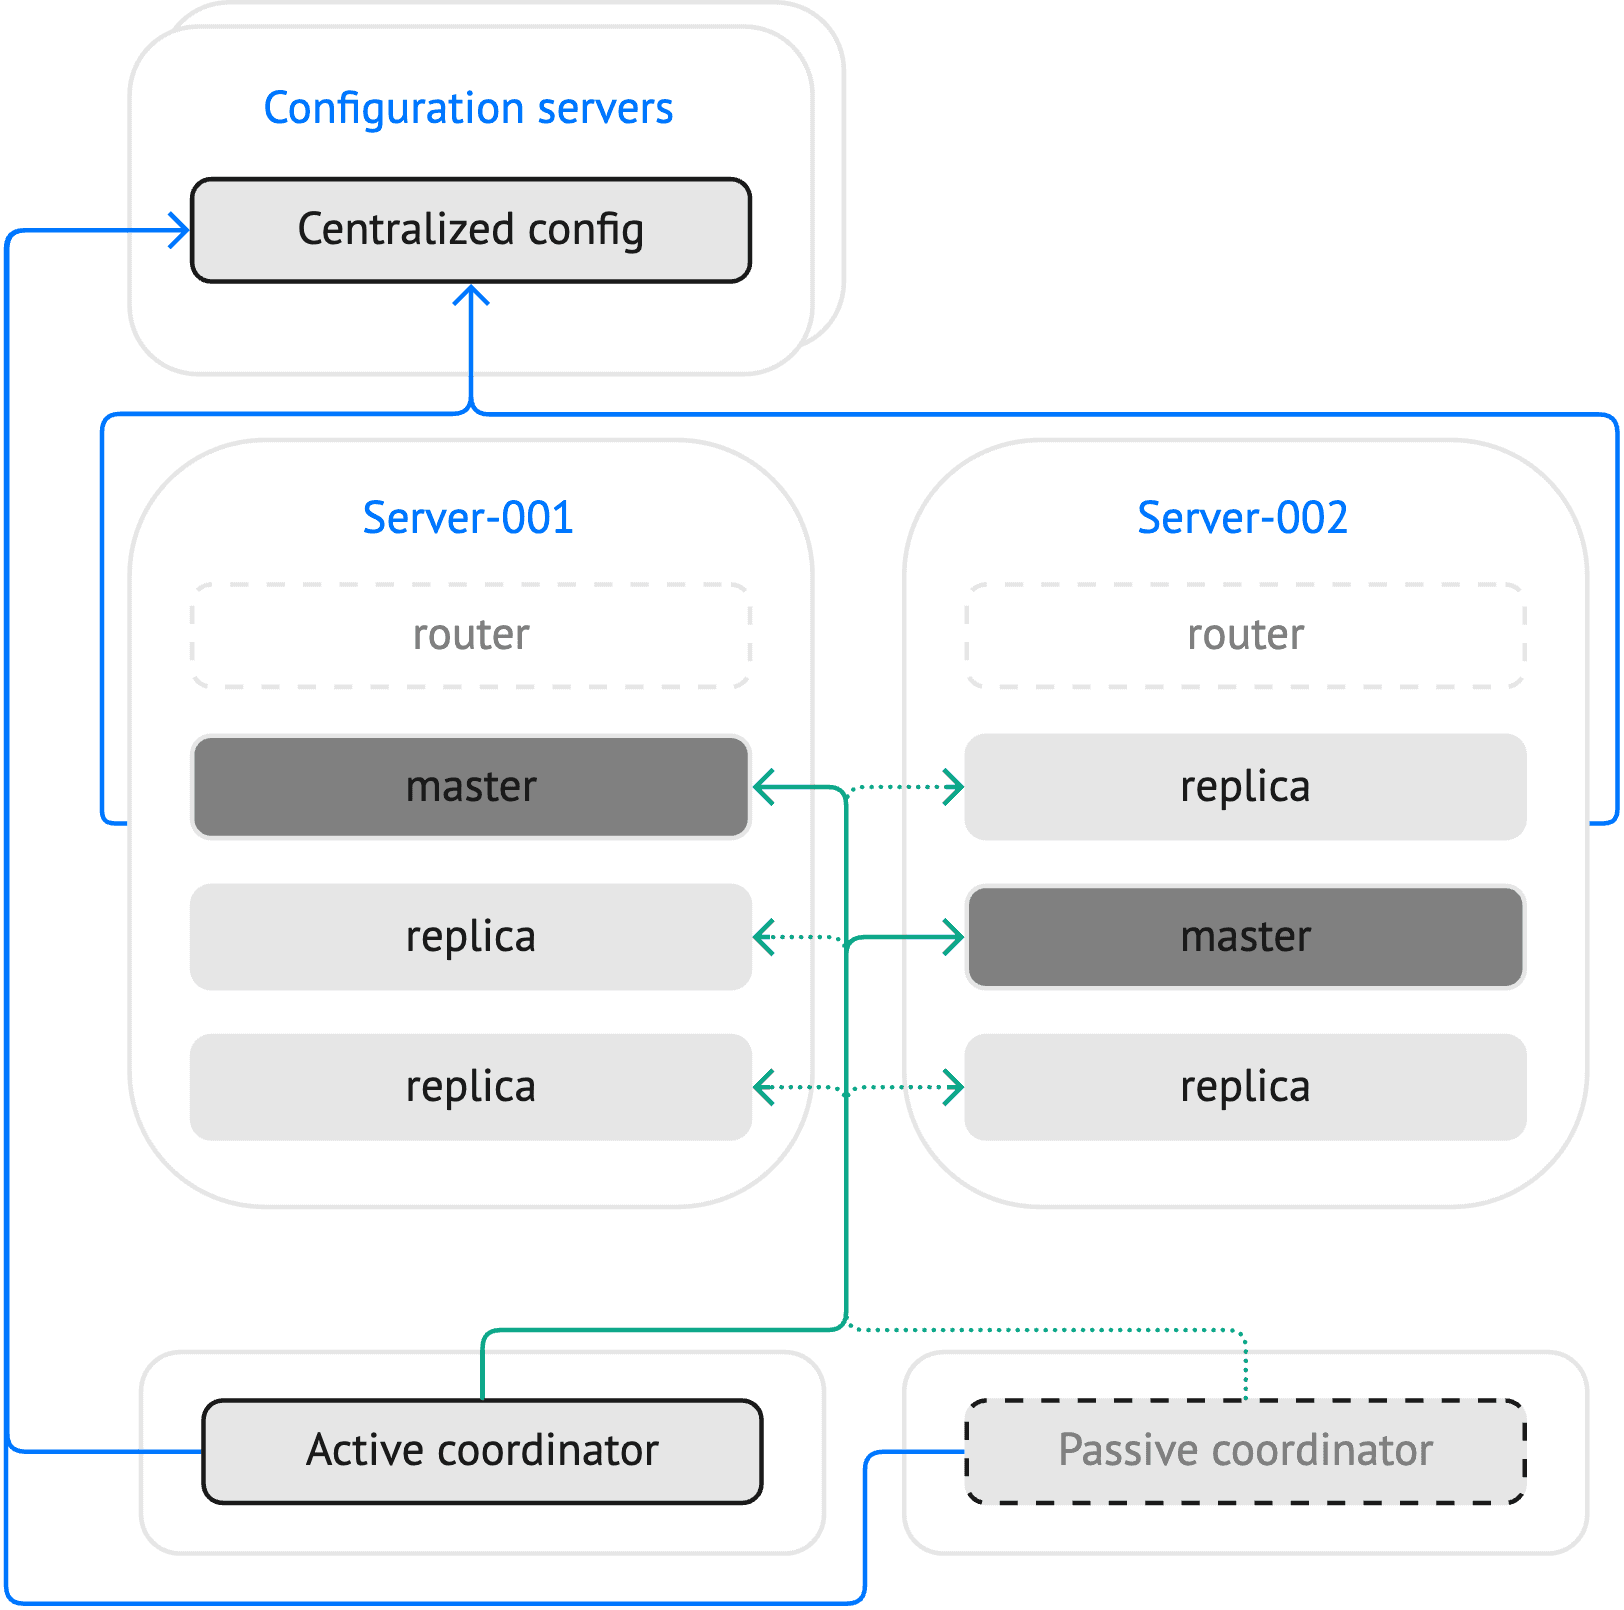
Основные шаги по использованию внешнего координатора аварийного переключения для нового кластера могут выглядеть так:
-
Настройте кластер для работы с внешним координатором. Основной шаг – задать значение
supervisedдля параметраreplication.failoverдля всех наборов реплик, которыми должен управлять внешний координатор. Для новых кластеров задайте значениеnativeдля параметра replication.bootstrap_strategy, чтобы координатор также управлял начальной загрузкой. -
Запустите настроенный кластер. Если параметру replication.bootstrap_strategy задано значение
nativeилиsupervised, набор реплик без выполненной начальной загрузки ожидает, пока координатор назначит лидера для начальной загрузки, и ни один экземпляр не выполнит начальную загрузку самостоятельно. После начальной загрузки экземпляры запускаются в режиме чтения, пока координатор не назначит лидера.Если вместо этого используется стратегия начальной загрузки
autoпо умолчанию, один экземпляр в наборе реплик без начальной загрузки может запуститься в режиме чтения-записи до запуска координатора. -
Запустите координатор аварийного переключения.
Если набор реплик ожидает лидера для начальной загрузки, запустите координатор до истечения replication.connect_timeout, либо запустите координатор до экземпляров. Для повышения отказоустойчивости можно запустить два и более координаторов аварийного переключения. В таком случае один координатор будет работать в активном режиме, а остальные – в пассивном.
После запуска кластера и координаторов аварийного переключения один экземпляр назначается мастером (если в наборе реплик уже нет мастер-экземпляра). После этого могут возникнуть следующие события:
- Если мастер-экземпляр выходит из строя, координатор аварийного переключения выполняет автоматическое переключение.
- Если активный координатор выходит из строя, другой координатор переходит в активный режим и выполняет автоматическое переключение.
После назначения мастер-экземпляра координатор аварийного переключения отслеживает статусы всех экземпляров в наборе реплик, отправляя запросы каждые probe_interval секунд. Для мастер-экземпляра координатор поддерживает крайний срок режима чтения-записи, который периодически продлевается каждые renew_interval секунд. Если все попытки продлить крайний срок в течение заданного в параметре (lease_interval) интервала времени завершаются неудачей, мастер переключается в режим чтения. Затем координатор назначает новый экземпляр мастером.
Если для поддержания состояния координаторов используется удаленное хранилище на базе etcd, можно выполнить ручное аварийное переключение.
Для повышения отказоустойчивости можно запустить два и более координатора аварийного переключения. В этом случае только один координатор работает в активном режиме и используется для управления ролью лидера в наборе реплик. Остальные координаторы работают в пассивном режиме и не выполняют назначений режима чтения-записи.
Для поддержания состояния координаторов Tarantool использует stateboard – удаленное хранилище на базе etcd. Это
хранилище использует те же параметры подключения, что и
централизованное хранилище конфигурации на базе etcd.
Если конфигурация кластера хранится в ключах <prefix>/config/* в etcd, координатор ищет свое
состояние в <prefix>/failover/*. Несколько примеров ключей, используемых для разных целей:
<prefix>/failover/info/by-uuid/<uuid>: содержит состояние координатора, идентифицируемого указаннымuuid.<prefix>/failover/active/lock: уникальный идентификатор (UUID) активного координатора.<prefix>/failover/active/term: своего рода токен ограждения, позволяющий отслеживать порядок, в котором координаторы переходят в активный режим (захватывают блокировку) с течением времени.<prefix>/failover/command/<id>: ключ, используемый для выполнения ручного аварийного переключения.
Чтобы настроить кластер для работы с внешним координатором аварийного переключения, выполните следующие шаги:
-
(Необязательно) Если для повышения отказоустойчивости нужно запустить несколько координаторов, настройте хранилище конфигурации на базе etcd, как описано в разделе Централизованные хранилища конфигурации.
-
Задайте значение
supervisedдля параметра replication.failover и значениеnativeдля параметра replication.bootstrap_strategy: -
Предоставьте пользователю, используемому для репликации, права на выполнение функции
failover.execute:credentials:users:replicator:password: 'topsecret'roles: [ replication ]privileges:- permissions: [ execute ]lua_call: [ 'failover.execute' ] -
(Необязательно) Настройте параметры, управляющие работой координатора аварийного переключения, в разделе failover:
Полный пример доступен на GitHub: supervised_failover.
До версии 3.2 в Tarantool использовался другой механизм предоставления доступа к выполнению Lua-функций. В Tarantool 3.0
и 3.1 раздел конфигурации credentials должен выглядеть так:
# Tarantool 3.0 and 3.1credentials:users:replicator:password: 'topsecret'roles: [ replication ]privileges:- permissions: [ execute ]functions: [ 'failover.execute' ]
Кроме того, необходимо создать функцию failover.execute в коде приложения. Например, для этого можно создать
пользовательскую роль:
-- Tarantool 3.0 and 3.1 ---- supervised_instance.lua --return {validate = function()end,apply = function()if box.info.ro thenreturnendlocal func_name = 'failover.execute'local opts = { if_not_exists = true }box.schema.func.create(func_name, opts)end,stop = function()if box.info.ro thenreturnendlocal func_name = 'failover.execute'if not box.schema.func.exists(func_name) thenreturnendbox.schema.func.drop(func_name)end,}
Затем включите эту роль для всех экземпляров хранилища:
# Tarantool 3.0 and 3.1roles: [ 'supervised_instance' ]
Для запуска координатора аварийного переключения необходимо выполнить команду tarantool с параметром
failover. Эта команда принимает путь к
файлу конфигурации кластера:
tarantool --failover --config instances.enabled/supervised_failover/config.yaml
Если конфигурация кластера хранится в etcd, файл config.yaml содержит
параметры подключения к хранилищу etcd.
Для повышения отказоустойчивости можно запустить два и более координаторов аварийного переключения. В этом случае только один координатор работает в активном режиме и используется для управления ролью лидера в наборе реплик. Подробнее см. в разделе Активные и пассивные координаторы.
Если для поддержания состояния координаторов аварийного переключения используется хранилище на базе etcd, можно
выполнить ручное аварийное переключение. Внешние инструменты могут использовать ключ <prefix>/failover/command/<id>
для выбора нового мастера. Например, утилита tt предоставляет команду
tt cluster failover для управления
аварийным переключением.